Ein Prompt für den Agenten über Nacht und ein Strategiespiel
Ich war unterwegs, und das einzige Gerät im Gepäck war ein MacBook Air M4 mit 24 GB Arbeitsspeicher. Alibaba hatte Qwen 3.8 27B am Tag vorher veröffentlicht. Ich war den ganzen Tag hibbelig, abends dann endlich etwas Freizeit. Also habe ich eine niedrige Quantisierung geladen (3 Bit) und lande bei etwa zwei Tokens pro Sekunde. Unbrauchbar für Chat / Live Vibecoding, aber gut genug für einen Test im pi-Harness:
„Can you create a html / js / css based space based strategy game?"
Ich hab's dann einfach laufen lassen.
Es lief die ganze Nacht und einen großen Teil des nächsten Tages. Herausgekommen ist ein spielbares rundenbasiertes Strategiespiel: eine Sternenkarte mit eigenen und fremden Systemen, Mineralien, Energie und Bevölkerung als Wirtschaft, vier Schiffsklassen mit unterschiedlichen Kosten und Reichweiten, ein Forschungsbaum. Es sah aus wie etwas, das ich als Teenager gerne gespielt hätte.
Zum Nachdenken
Das Modell hat nicht nach dem Spiel aufgehört. Es hat eine Simulation geschrieben, um das Spiel durchzuspielen (eine Seite von einer KI gesteuert, die andere so, wie ein Mensch spielen würde) und danach ausgerechnet, wie leicht es zu schlagen ist.
Es hat nicht gewartet, bis mir die Balance-Probleme auffallen. Es hat sie selbst gefunden, nachts um drei auf einem Notebook.
Das zweite Experiment, wieder zu Hause mit der Keller-KI, wo dasselbe Modell viel komfortabler läuft: Ich habe ihm einen einfachen Planetengenerator gegeben, den ich vor sieben Jahren geschrieben hatte. Wieder ein einfacher Prompt. Zurück kam ein Strategiespiel mit prozedural generiertem Universum, erzählerischen Momentaufnahmen zwischen den Zügen, eigenständigen Charakteren und Handels- und RPG-Mechaniken in einem Game Loop. Zweimal habe ich nachprompten müssen, um kleine Fehler zu glätten. Entstanden ist TS UNIVERSE — The Long Drift.
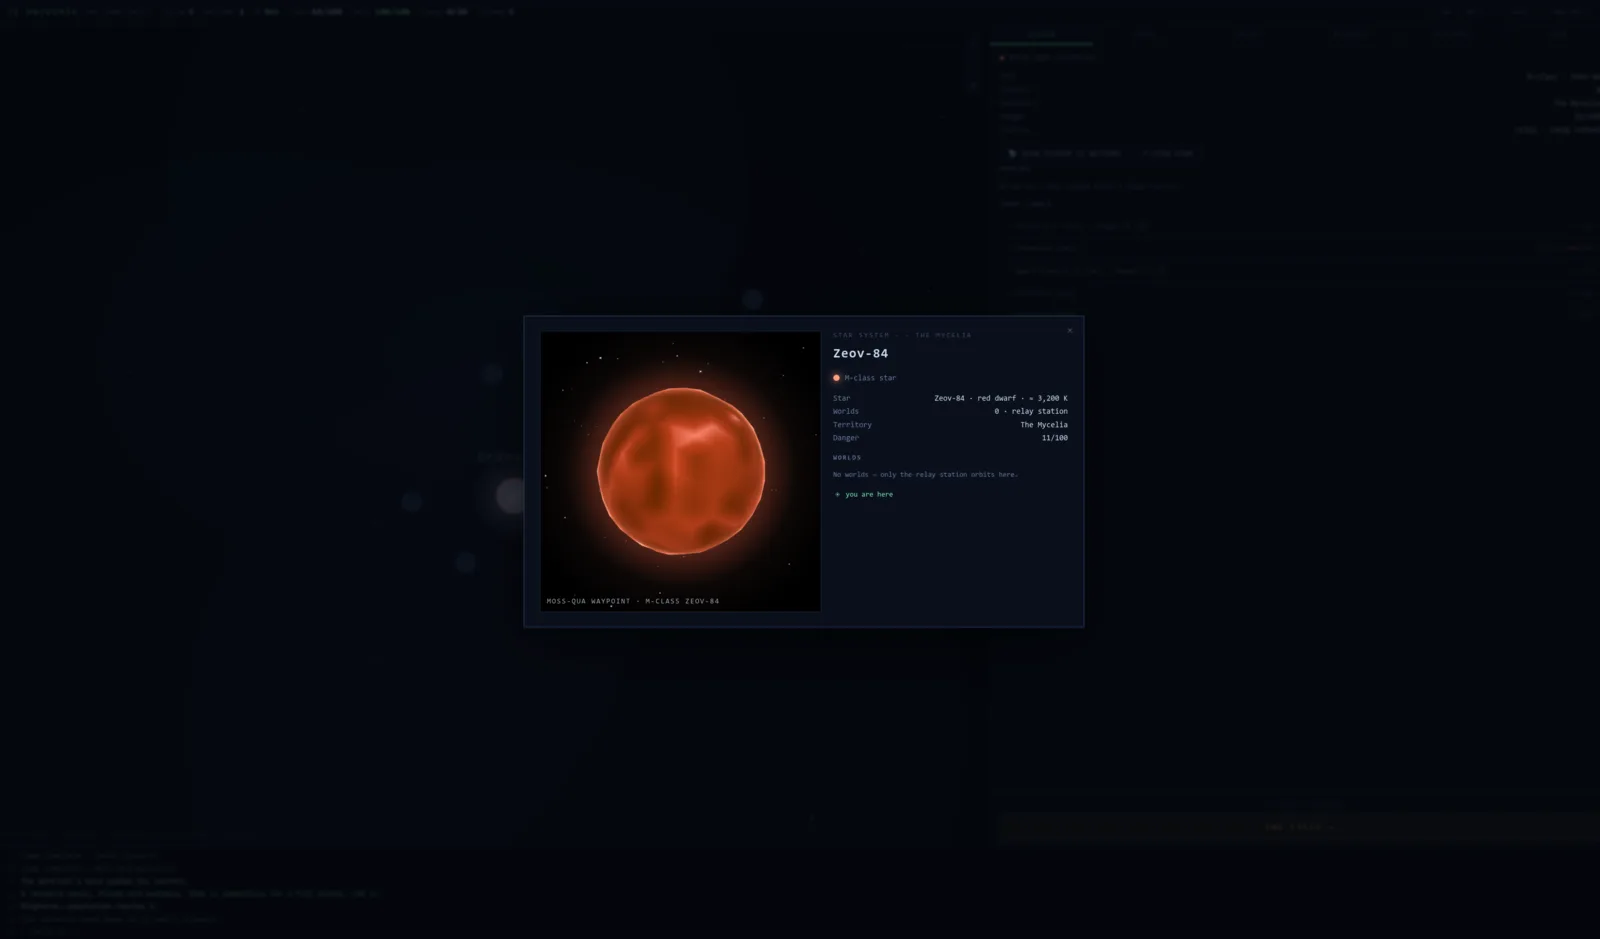
Der Haken
Bei kleiner Hardware: Thinking bei Qwen 3.8 27b dauert ewig. Ein Ein-Prompt-Auftrag antwortet in Stunden, selbst wenn das Prompt und die Aufgabe klein sind. Für alles Interaktive taugt das Modell mit zu schwacher Hardware nicht: Ich sitze nicht davor und schaue beim Nachdenken zu, während ich überlege, was ich als Nächstes tippe.
Für Batchverarbeitung ist es damit trotzdem sehr brauchbar.
Erkenntnisse
Wir bewerten Modelle nach Benchmarks und Chat. Das belohnt schnelle und gefällige Antworten. Gemessen habe ich aber hier, wie viel in sich geschlossene, prüfbare Arbeit ein Modell allein tragen kann, bevor es mich braucht. Die Antwort wäre vor wenigen Monaten „kaum etwas" gewesen, und heute ist sie „ein komplettes Spiel".
Im Batch über Nacht kann es auch auf eigentlich zu schwacher Hardware brauchbare Ergebnisse liefern. Im Chat braucht man schon etwas stärkeres. Aber nicht nur das Modell spielt eine Rolle, auch der Harness, hier war das Pi. Er hat dafür gesorgt, dass im agentischen Loop ein besseres Ergebnis herausgekommen ist als das mit klassischen Entwicklungsumgebungen + KI Chat der Fall gewesen wäre.