Lokale KI im Test: Das deutsche Modell verliert beim Deutsch
Viele Unternehmen möchten KI nutzen, aber ihre Daten nicht in die Cloud geben. Was leisten Modelle, die komplett auf eigener Hardware laufen? Und welches nimmt man für deutsche Texte?
Ich habe vier aktuelle Open-Weight-Modelle getestet: drei beliebte Modelle aus China und eins aus Deutschland (Kolibri-1). Die Hardware sind zwei Grafikkarten aus dem Consumer-Bereich (RTX 5090 und RTX 3090) in einem Consumer-System mit 128 GB RAM.
Die Aufgaben
Jedes Modell hat acht Aufgaben aus der Praxis gelöst, mit je 0 bis 10 Punkten nach festen Kriterien:
- Rechnungen gegen Bestellungen, Preislisten und Abrechnungsregeln prüfen
- eine Monatsabrechnung von Hand erstellen, einschließlich Gutschriften und Sonderpreisen
- Fehler in bestehendem Code finden und beheben
- eine Terminplanung nach Spezifikation programmieren (Zeitzonen, Zeitumstellung)
- eine Web-Anwendung bauen (Rechnungseditor)
- einen deutschen Aushang korrigieren, auf inhaltliche Fehler prüfen und in Einfache Sprache übertragen
- schwere Algorithmen-Aufgaben lösen und ein Wissensquiz beantworten
Das Ergebnis
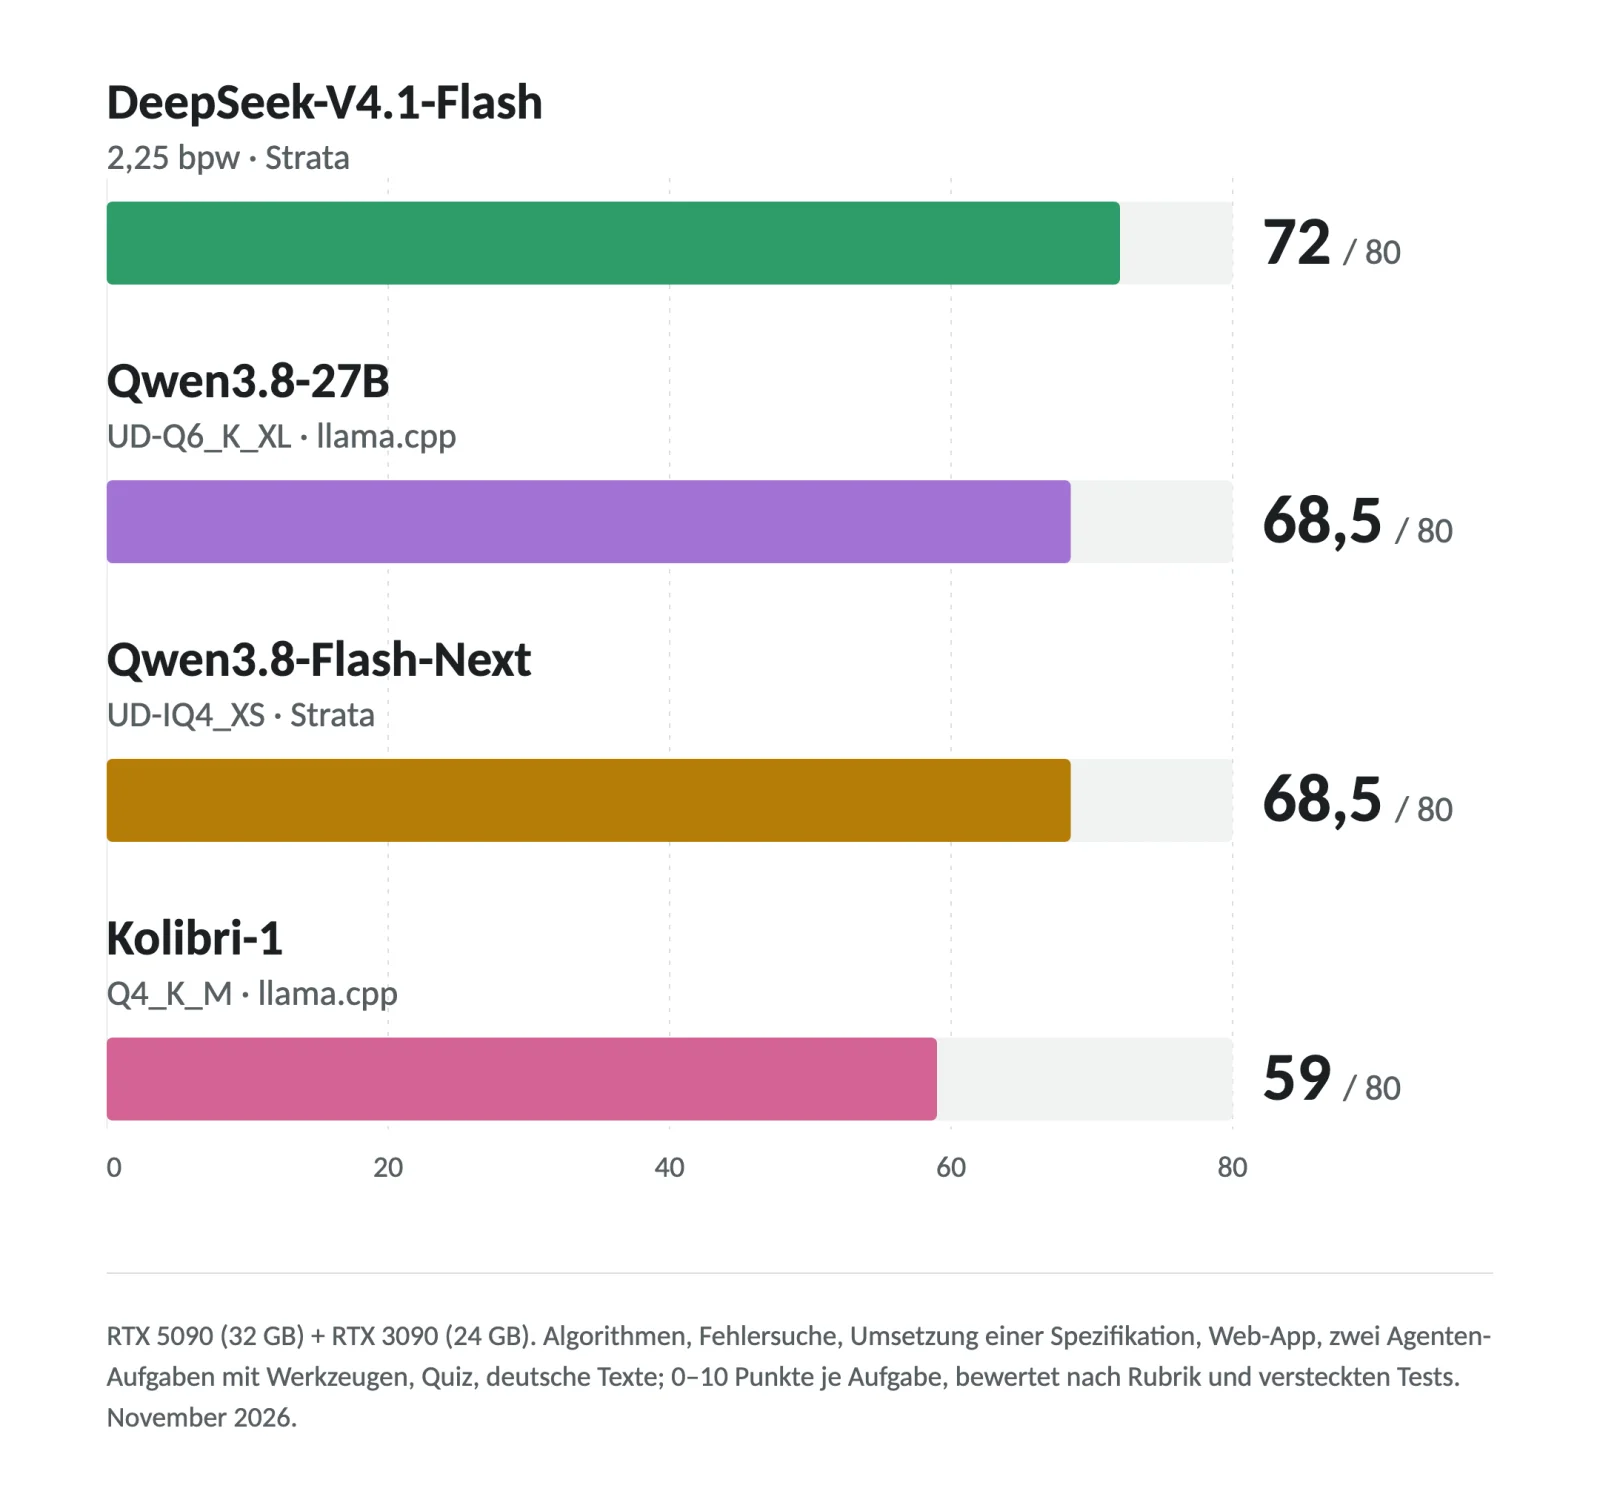
Von maximal 80 Punkten:
- DeepSeek-V4.1-Flash, 2,25-Bit-Quantisierung: 72
- Qwen3.8-27B, UD-Q6_K_XL: 68,5
- Qwen3.8-Flash-Next, UD-IQ4_XS: 68,5
- Kolibri-1, Q4_K_M: 59
Die beiden Qwen-Modelle teilen sich Platz zwei.
Deutsch können die chinesischen Modelle besser
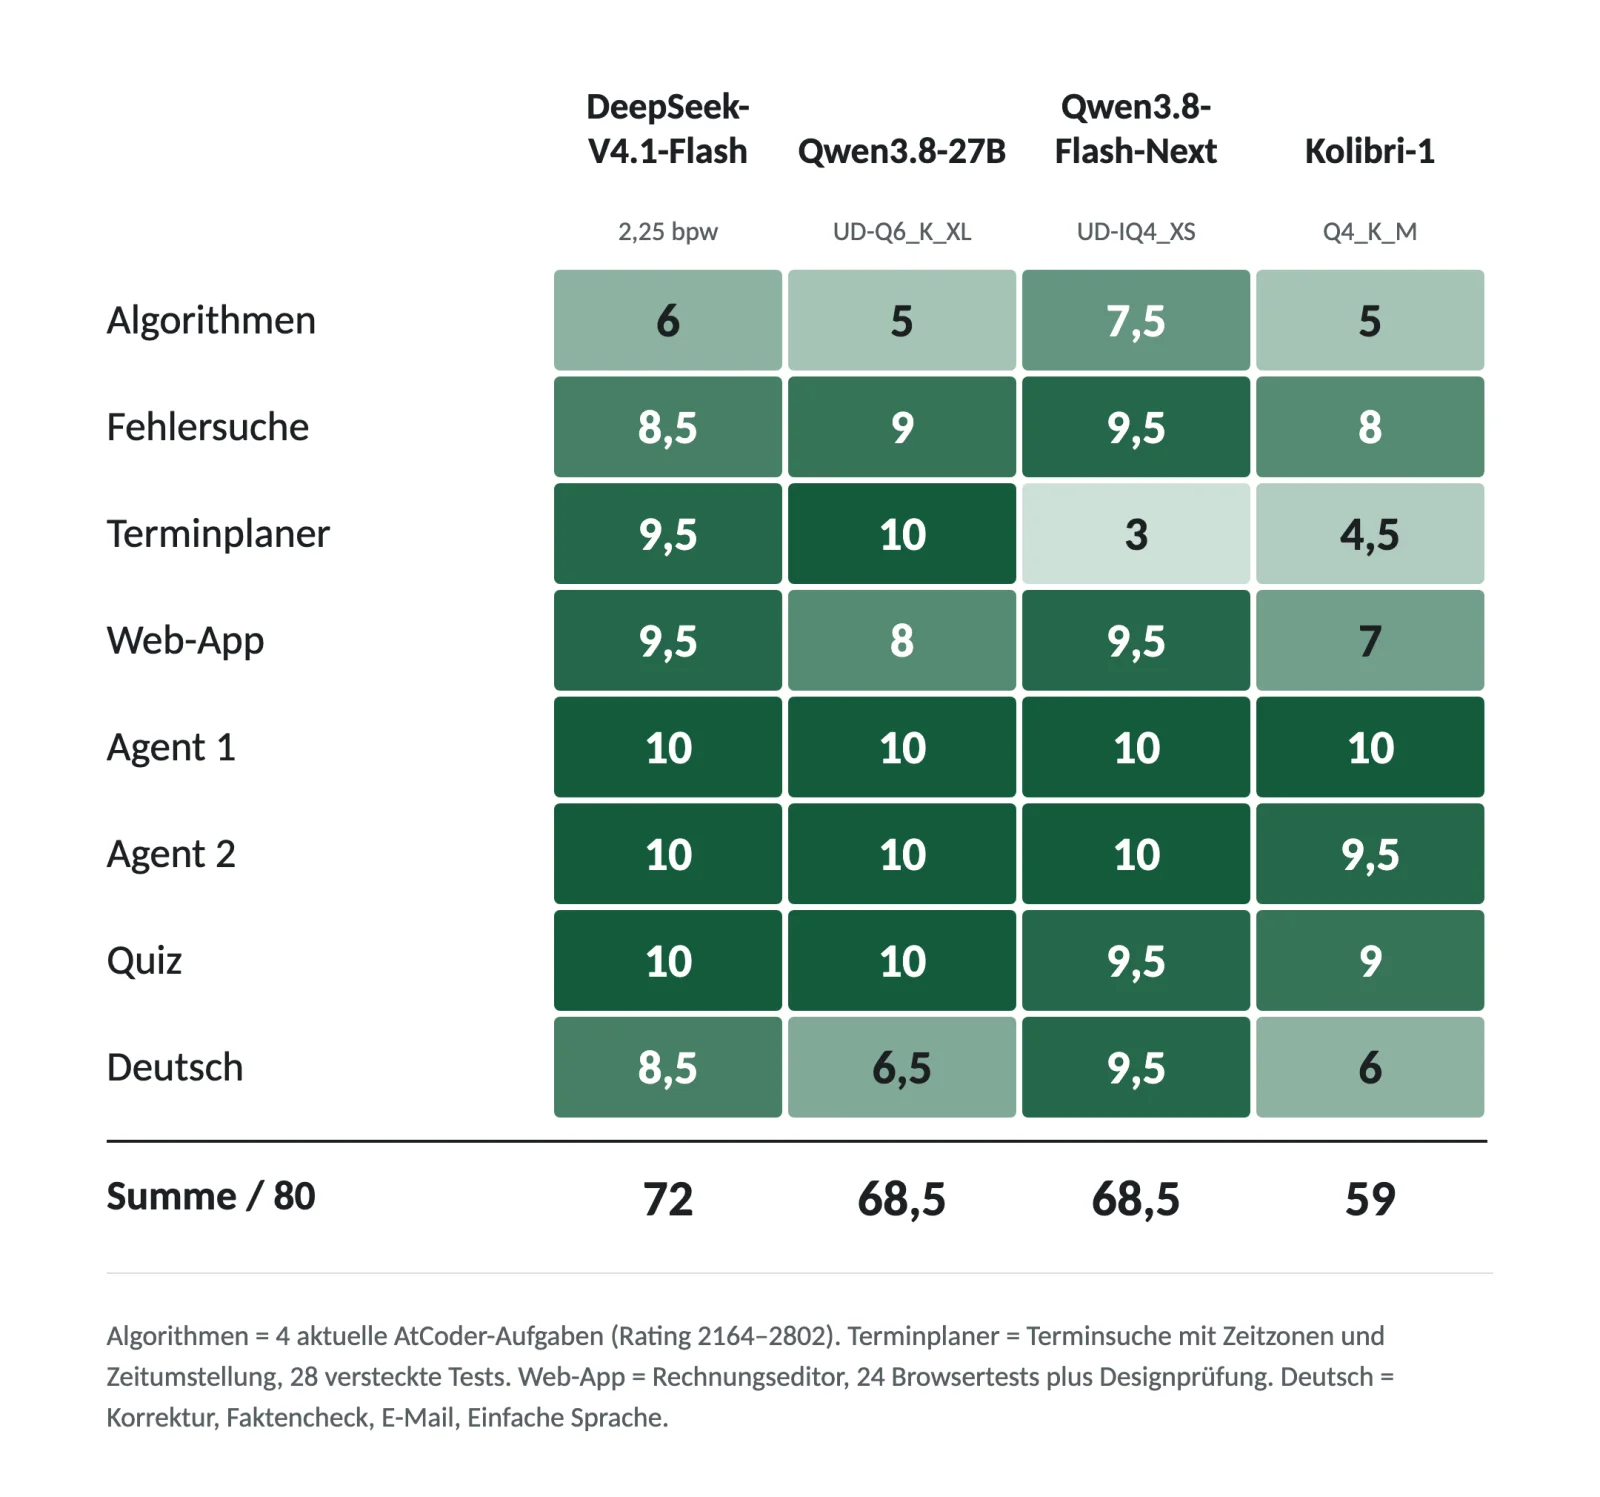
Ausgerechnet bei der deutschen Textaufgabe lag das deutsche Modell hinter allen drei chinesischen. Die Aufgabe verlangte mehr als Rechtschreibung: Der Aushang sollte korrigiert, auf inhaltliche Fehler geprüft und in Einfache Sprache übertragen werden. Qwen3.8-Flash-Next erreichte 9,5 Punkte, DeepSeek-V4.1-Flash 8,5, Qwen3.8-27B 6,5 und Kolibri-1 nur 6.
Ein Modell aus Deutschland ist also nicht automatisch das beste für deutsche Texte. Das ist kein Urteil über deutsche Modelle insgesamt, getestet habe ich nur eines. Wer KI für Korrespondenz oder Fachtexte einsetzt, sollte das Modell aber gezielt für diese Aufgabe auswählen, statt nach Herkunft, und die Ergebnisse gegenlesen.
Genaue Vorgaben trennen die Modelle
Noch weiter auseinander liegen die Ergebnisse beim Terminplaner nach Spezifikation: von 3 bis 10 Punkten. Qwen3.8-27B hat ihn fehlerfrei umgesetzt, ausgerechnet das schnelle Qwen3.8-Flash-Next kam nur auf 3. Zeitzonen und Zeitumstellung sind genau die Details, bei denen ein Modell entweder sauber arbeitet oder nicht.
Agentisches Handeln beherrschen alle vier
Jedes Modell hat die Rechnungsprüfung und die Monatsabrechnung (fast) fehlerfrei erledigt. Die Modelle haben selbstständig Dateien gelesen, Regeln angewendet, Fallen in den Daten erkannt und unberechtigte Kundenforderungen begründet abgelehnt. Solche Abläufe kann man heute lokal betreiben.
Schnell heißt nicht schlecht
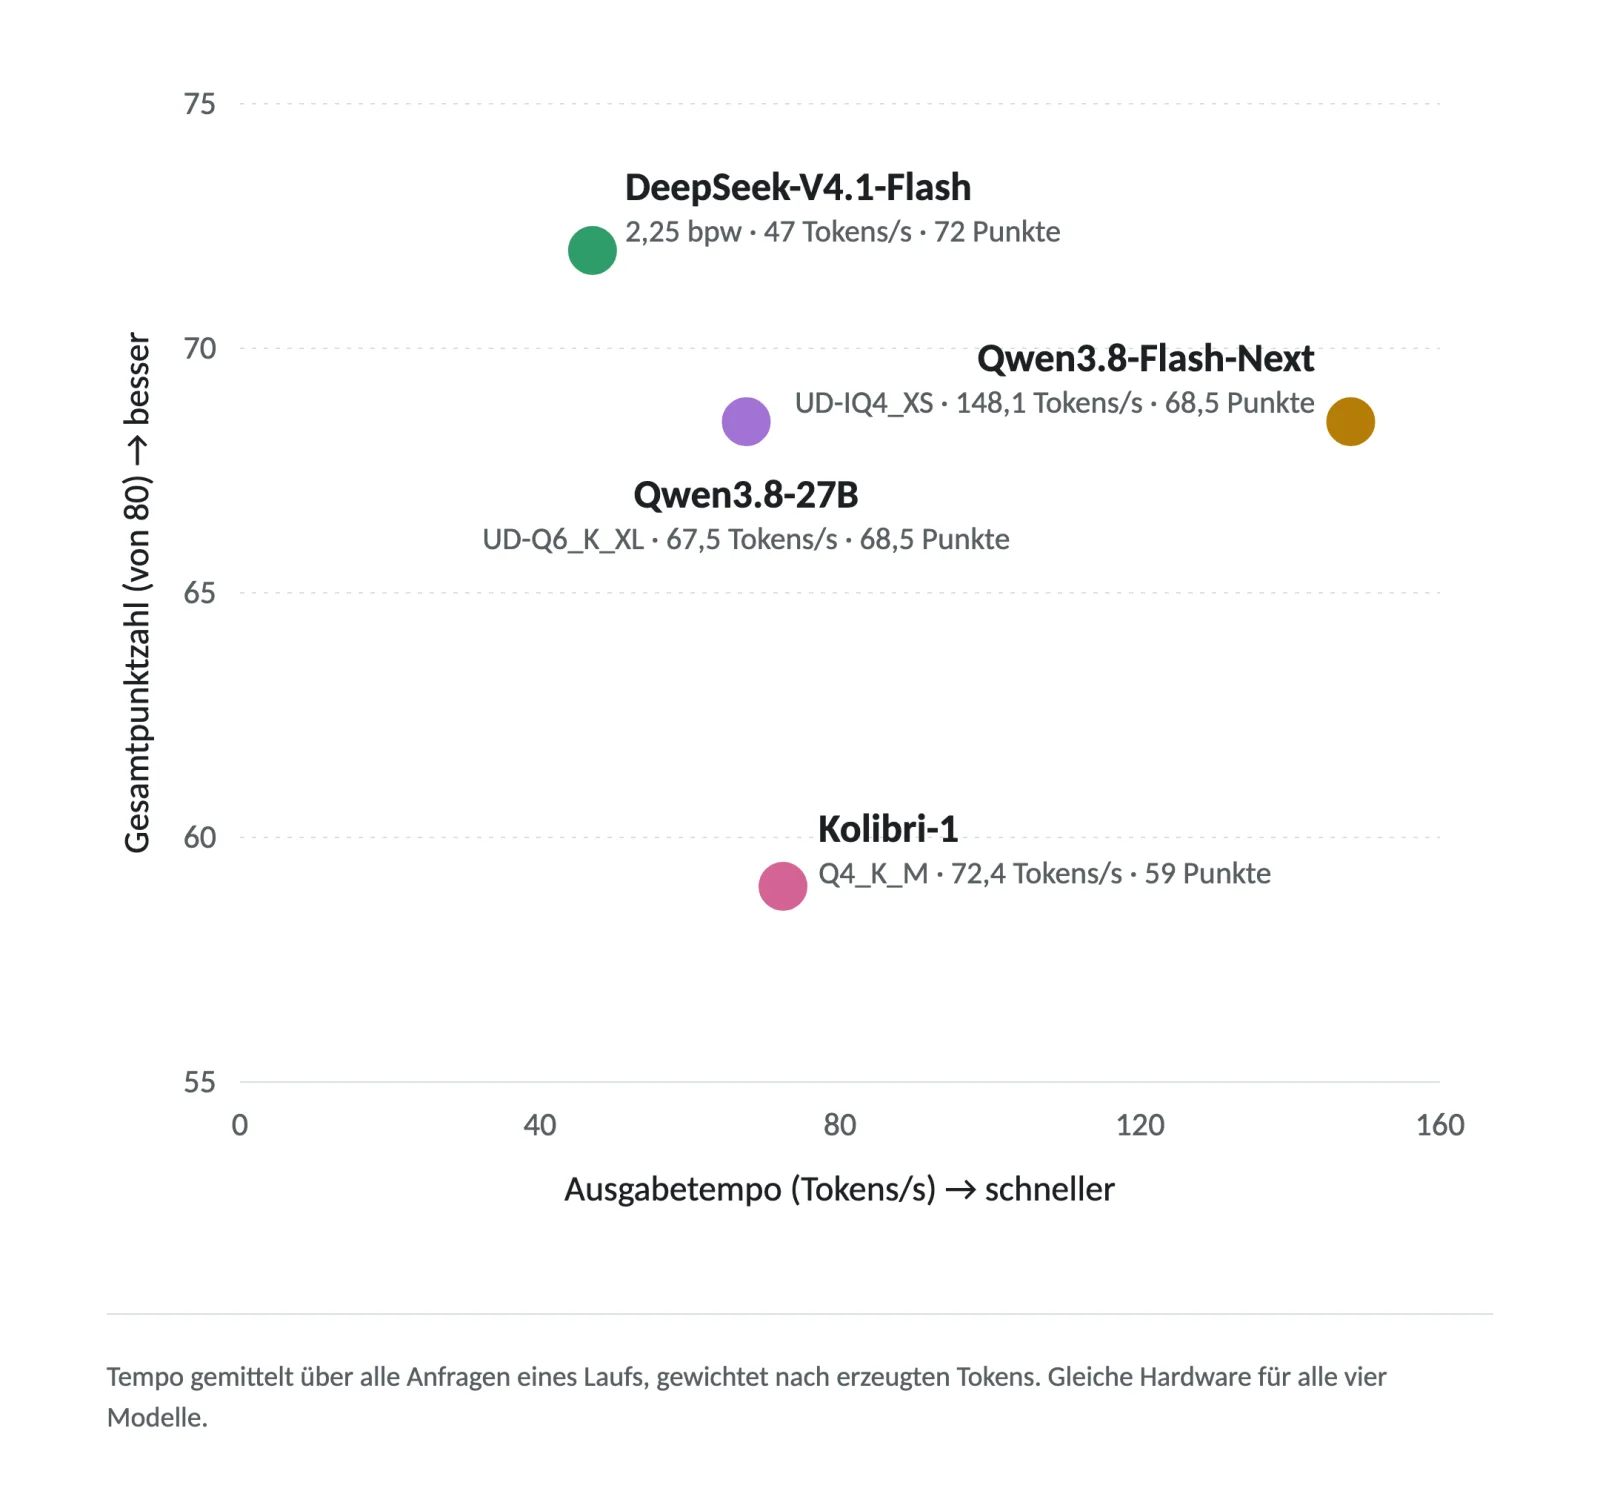
Qwen3.8-Flash-Next erzeugt 148 Tokens pro Sekunde und erreicht dieselbe Punktzahl wie das 27B-Modell. Der komplette Testlauf dauerte damit 56 statt 135 Minuten. Das ist auch mein bevorzugtes Modell für tägliche Aufgaben.
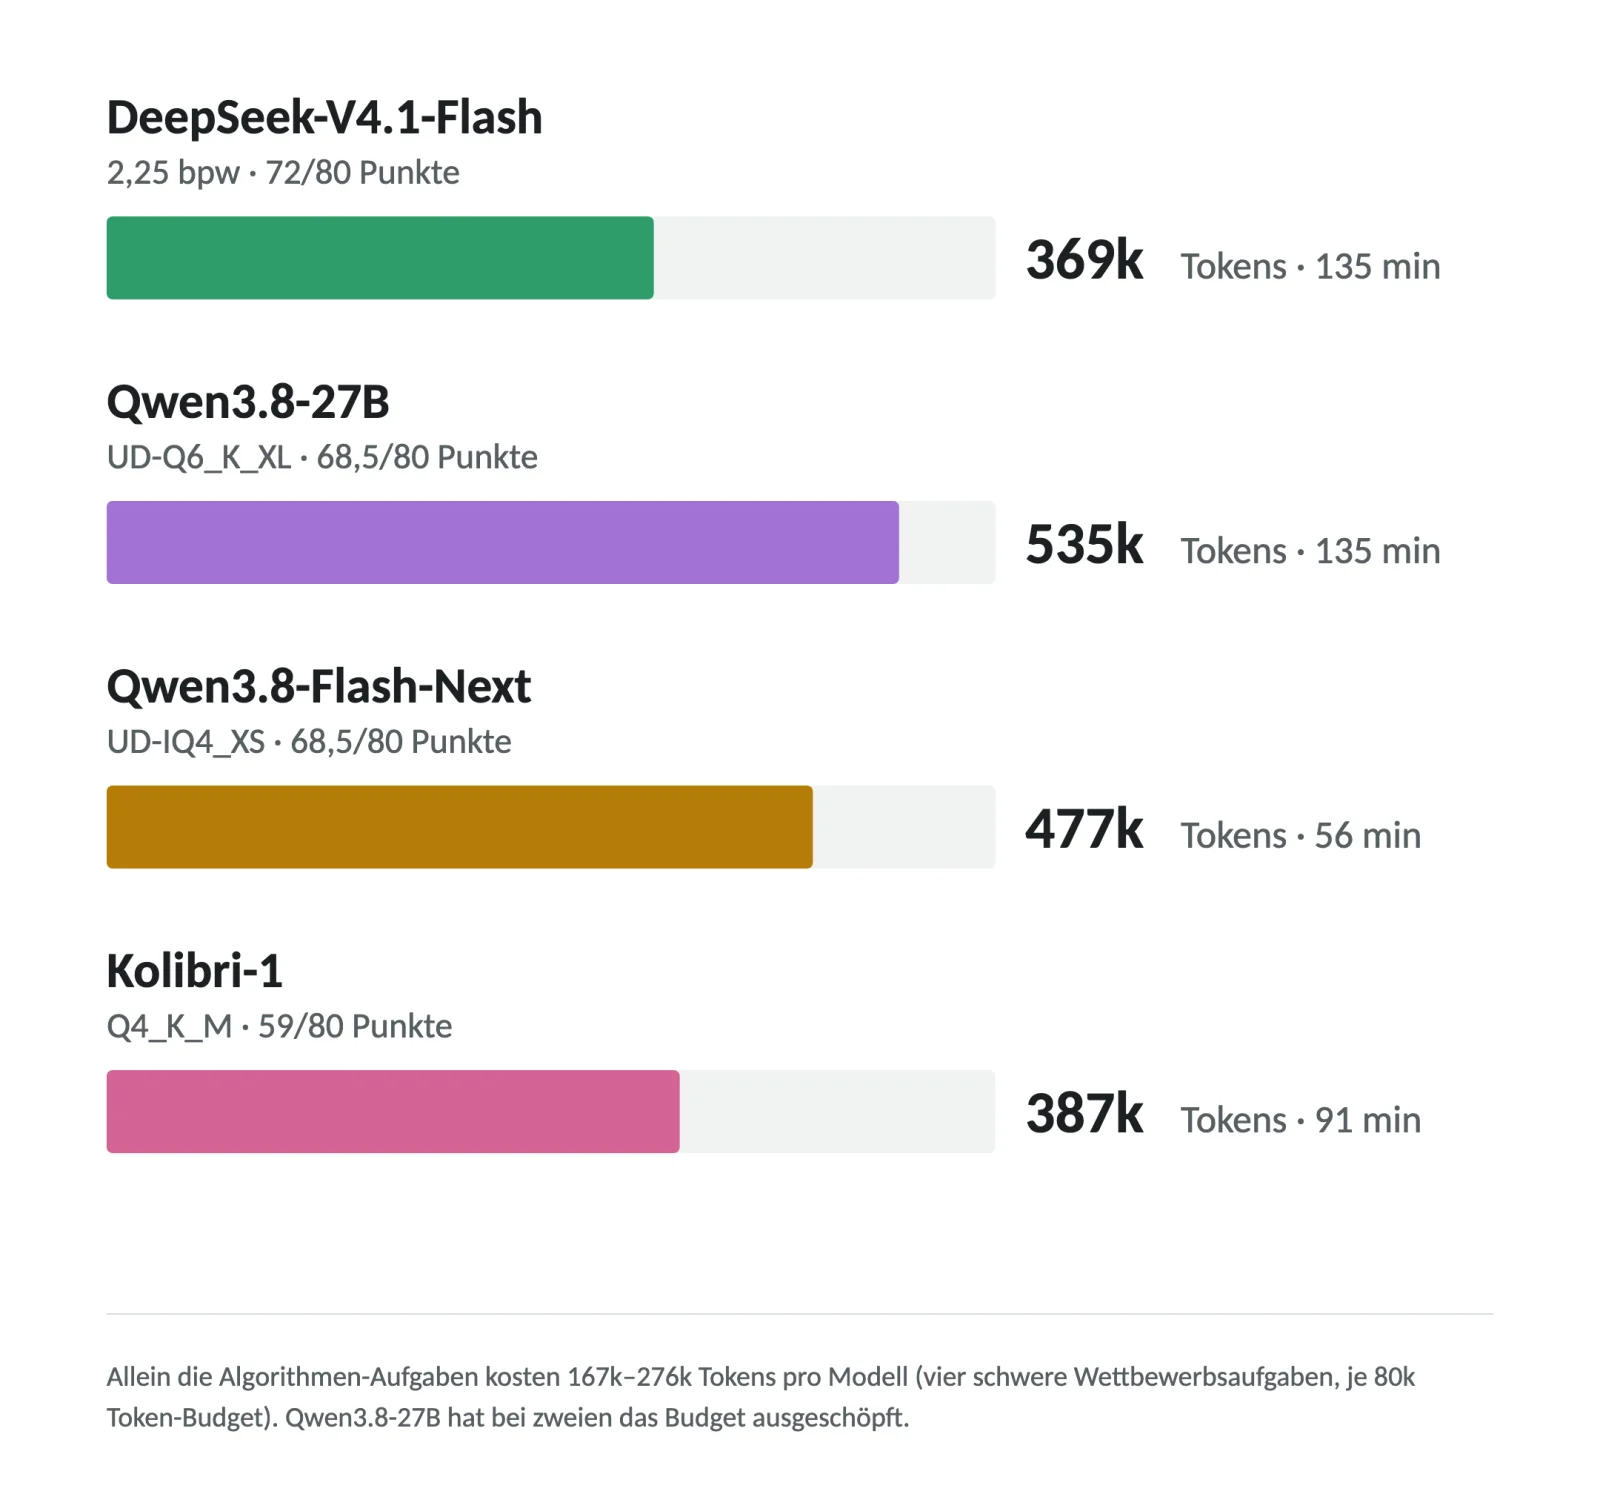
Mehr Nachdenken brachte auch keine bessere Punktzahl. Qwen3.8-27B hat für alle acht Aufgaben rund 535.000 Tokens erzeugt, die meisten im Test. DeepSeek-V4.1-Flash kam mit 369.000 aus und holte trotzdem die meisten Punkte.
Stark komprimierte Modelle können trotzdem viel
DeepSeek-V4.1-Flash, auf 2,25 Bit pro Gewicht verkleinert, holt die meisten Punkte, ist aber das langsamste Modell im Test. Das liegt an der Größe: 552 Milliarden Gewichte.
Fazit
Lokale KI ist für viele Abläufe in Buchhaltung, Sachbearbeitung und Softwareentwicklung praxistauglich, auf Hardware, die auf den Schreibtisch passt. Entscheidend ist, für jede Aufgabe das passende Modell zu wählen und es vorher mit den eigenen Abläufen zu testen. Das gilt auch für die Sprache: Welches Modell gutes Deutsch schreibt, zeigt nur ein Test.
Sie überlegen, KI im eigenen Haus zu betreiben, ohne Daten in die Cloud zu geben? Schreiben Sie mir, ich teile gern meine Erfahrungen. Wie ein solches Projekt abläuft, steht unter KI auf eigener Hardware.